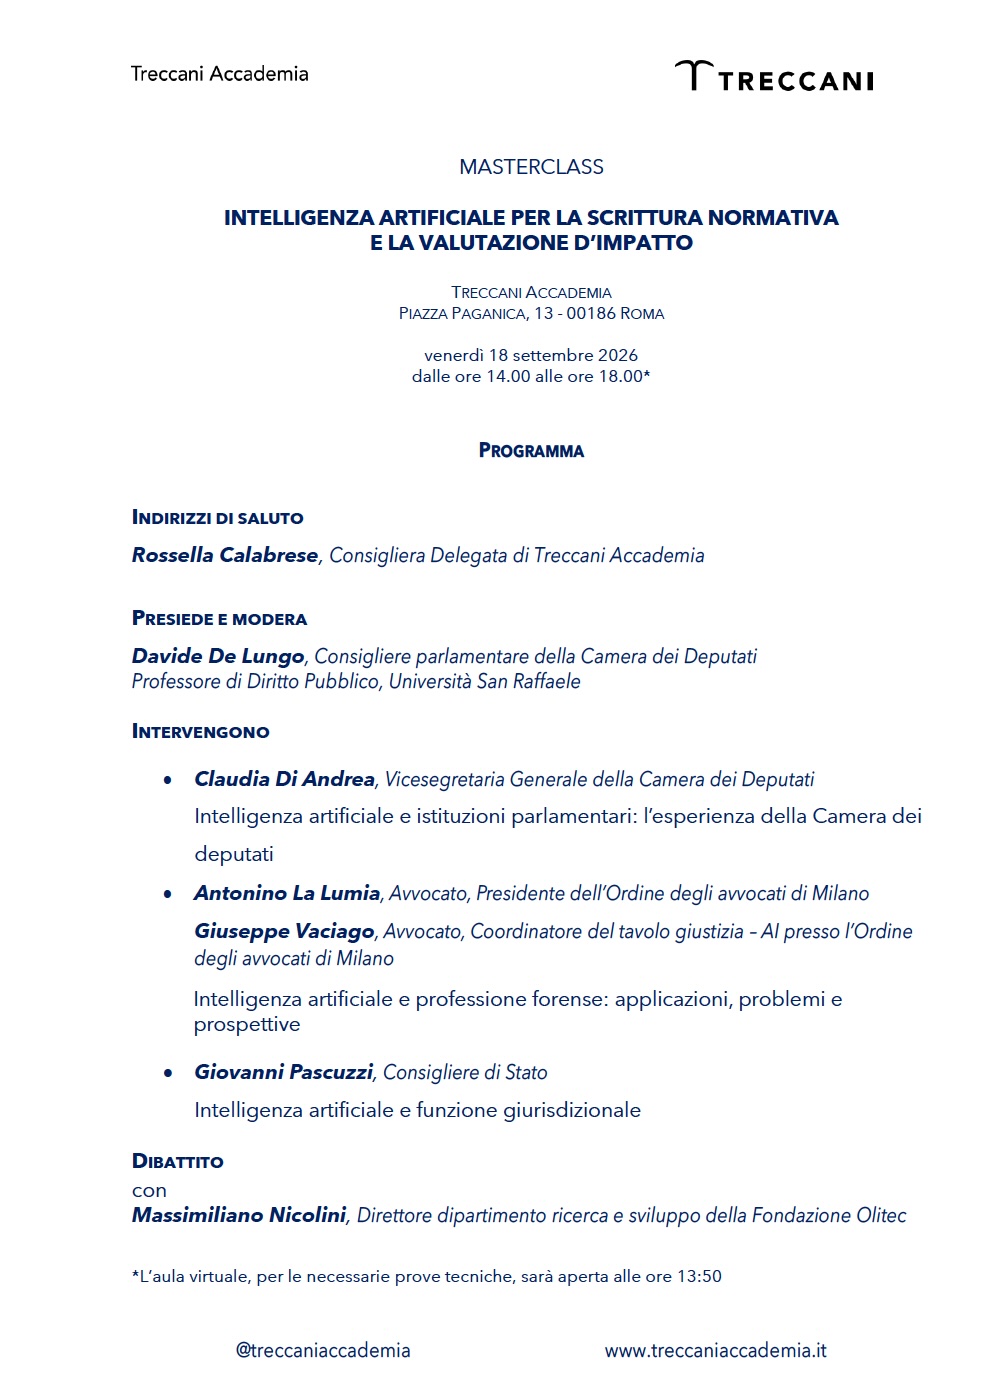
 Il 18 settembre 2026 si è tenuto a Roma, presso Treccani Accademia, il primo dei quattro incontri della masterclass «Intelligenza artificiale per la scrittura normativa e la valutazione d’impatto», (pdf della brochure) diretta da Davide De Lungo.
Pubblico qui le slide che ho proiettato.
La giornata
La prima relazione è stata tenuta da Claudia Di Andrea, Vicesegretaria generale della Camera dei deputati. È stata la relazione cornice, nella quale sono stati elencati tutti i profili connessi all’uso dell’intelligenza artificiale nelle istituzioni parlamentari: fra gli altri, i possibili usi nel ciclo della regolazione e le iniziative concrete varate dalla Camera.
L’organizzazione ha voluto che di intelligenza artificiale si parlasse anche dal punto di vista dell’avvocatura e della giurisdizione.
Giuseppe Vaciago, coordinatore del tavolo giustizia e AI presso l’Ordine degli avvocati di Milano, ha esposto le iniziative assunte dall’ordine meneghino sulle applicazioni per l’avvocatura.
Io ho svolto la relazione intitolata «Intelligenza artificiale e funzione giurisdizionale».
L’ultimo intervento è stato di Massimiliano Nicolini, direttore del dipartimento ricerca e sviluppo della Fondazione Olitec, che ha illustrato le questioni tecniche di cui si parlerà nei prossimi incontri, a cominciare dagli strumenti che permettono all’intelligenza artificiale di “girare” in locale, depotenziando di molto il problema della diffusione dei dati.
Che cosa ho detto
Il mio intervento si è diviso in due parti. Nella prima ho ricostruito il contesto entro cui un magistrato può oggi sperimentare. Nella seconda ho raccontato che cosa ho imparato sperimentando, ordinandolo lungo quello che ho chiamato un percorso di quattro gradini.
I limiti, e chi li ha scritti
Uso l’intelligenza artificiale generativa da studioso e da giudice, e le due cose non hanno le stesse regole. Da studioso il vincolo è il metodo. Da giudice i vincoli sono scritti, e vengono da testi come i seguenti:
- la «Carta etica europea sull’uso dell’intelligenza artificiale nei sistemi giudiziari e nel loro ambiente», adottata dalla CEPEJ il 3 dicembre 2018;
- le «Raccomandazioni sull’uso dell’intelligenza artificiale nell’amministrazione della giustizia» del Consiglio superiore della magistratura, dell’8 ottobre 2025, aggiornate il 22 luglio 2026;
- il documento «Intelligenza artificiale e Giustizia amministrativa: strategie di impiego, metodologie e sicurezza», del Segretariato generale della Giustizia amministrativa, Servizio per l’informatica.
Sullo sfondo, l’art. 15 della legge 23 settembre 2025, n. 132 (d’ora in poi: legge sull’intelligenza artificiale), che riserva sempre al magistrato ogni decisione sull’interpretazione e sull’applicazione della legge, sulla valutazione dei fatti e delle prove e sull’adozione dei provvedimenti.
La Carta della CEPEJ vale per tutti i sistemi giudiziari europei. Le raccomandazioni del Consiglio superiore vincolano i magistrati ordinari. Il documento della Giustizia amministrativa è quello che riguarda me.
Il documento della Giustizia amministrativa fissa quattro limiti operativi: l’attività di elaborazione resta affidata al giudice in via esclusiva; è esclusa la generazione di testi di qualsiasi tipologia; l’addestramento avviene sui soli dati del database interno; per ogni caso d’uso è progettata una pipeline disegnata da giudici e ingegneri insieme, così che ogni passaggio sia catturato per essere spiegato. Preferisce, per questo, parlare di «intelligenza accelerata» più che di intelligenza artificiale.
Le due delibere del Consiglio superiore della magistratura raccontano un movimento. Nel 2025 il perimetro era stretto. Nel 2026, acquisite le garanzie tecniche sul sistema in dotazione agli uffici, gli usi ammessi passano da sette a dodici, purché restino nella «fase analitica e ricostruttiva del processo» e ricorrano cinque condizioni cumulative.
Restano aperte alcune questioni, che ho indicato una per una. La principale riguarda il confine: fra i nuovi usi consentiti compare il confronto fra le posizioni processuali delle parti ai fini dell’individuazione del thema decidendum, ma individuare il thema decidendum non è operazione descrittiva. Il rischio non è che la macchina decida al posto del giudice: è che il giudice parta da un punto che non ha scelto. Le raccomandazioni del 2025 chiedevano, non a caso, di preservare la possibilità di resistere alla macchina.
C’è poi un dato che considero decisivo, e che viene dalla ricognizione tecnica del Consiglio del 29 aprile 2026. Catalogando elenchi di beni immobili in ambiente istituzionale protetto, su documenti già trattati con OCR, con l’istruzione esplicita di limitarsi ai documenti forniti, il sistema ha inserito il riferimento a un Comune inesistente senza segnalarlo come incerto. L’ambiente chiuso riduce il rischio: non lo elimina.
La conclusione è che la funzione giudiziaria richiede sistemi progettati fin dall’origine per il dominio giuridico, con tracciabilità delle fonti e verificabilità degli output. Quella piattaforma ancora non c’è. E poiché l’autonomia decisionale, il divieto di profilazione e la parità informativa fra le parti non sono principi della sola giurisdizione ordinaria, ho proposto una sede comune delle magistrature, aperta all’avvocatura: una voce sola, nel momento in cui si deve dire all’industria di che cosa si ha bisogno.
Una sperimentazione in corso alla Corte di cassazione
Aggiungo qui una notizia che non era nelle slide e che illustra bene quanto precede (Fonte: Ivan Cimmarusti, Il Sole 24 Ore, 16 settembre 2026).
Tra luglio e agosto 2026, nella sezione tributaria, un «agente AI» costruito su Copilot ha affiancato in via sperimentale magistrati e personale amministrativo nella preparazione della scheda di spoglio dei ricorsi per cassazione.
L’addetto all’Ufficio per il processo carica gli atti necessari e l’agente restituisce una scheda uniforme con materia, sviluppo del processo, motivi del ricorso e difese della controparte. L’agente lavora solo su quegli atti: non cerca precedenti e non è collegato alla banca dati Italgiure né alla piattaforma di gestione. L’operatore confronta la scheda con il fascicolo e il magistrato ne supervisiona il contenuto. Solo dopo la scheda viene inserita manualmente nel sistema.
L’articolo richiama come cornice l’AI Act, l’articolo 15 della legge italiana sull’intelligenza artificiale e la delibera del CSM dell’8 ottobre 2025, aggiornata il 22 luglio 2026, che ammette Copilot per classificare, riassumere e analizzare gli atti. Sono previste anche cautele di sicurezza: account istituzionale, spazio riservato al Ministero, dati che restano in Italia e non vengono usati per addestrare i modelli, caricamento limitato alle informazioni necessarie.
Gli esiti preliminari, definiti «incoraggianti», sono stati illustrati il 15 settembre al primo presidente e ai presidenti di sezione. La prova proseguirà e si valuta l’estensione alle altre sezioni della Corte.
L’obiettivo dichiarato è alleggerire il lavoro documentale, uniformare le schede e organizzare meglio le informazioni processuali, senza automatizzare la decisione.
Quattro gradini
Nella seconda parte del mio intervento ho raccontato le mie sperimentazioni, disponendole secondo la progressione che ho seguito.
Primo gradino: il chatbot nudo. Gli chiedo, lui risponde. Ho posto la stessa domanda a tre sistemi, poi lo stesso compito a cinque: individuare fatti e principio di diritto di una sentenza, Cass., sez. un., 26 gennaio 1971, n. 174, il caso Meroni, circa 55.000 caratteri da ridurre a 3.000. [Prospetto comparativo delle risposte e testo della sentenza (pdf)]
Il risultato è istruttivo. Tutti e cinque arrivano allo stesso principio di diritto, con differenze di grana. Ma quando avevo chiesto loro che cosa sapessero fare per un giurista, le risposte divergevano, e ciascuno si attribuiva qualcosa che gli altri non nominavano [la risposta di Claude: pdf; la risposta di Gemini: pdf; la risposta di ChatGPT: pdf]. Dove c’è un testo contro cui verificare, convergono. Dove non c’è, divergono. Anche il resoconto che un sistema dà di sé stesso è un output, e va verificato come ogni altro.
A questo gradino ho accennato ai tre errori strutturali di cui ho scritto altrove: l’allucinazione, che produce testo plausibile e falso; la sicofantia, che asseconda chi interroga invece di contraddire le premesse sbagliate della domanda; il bias linguistico, che riconduce istituti italiani a categorie di common law.
Secondo gradino: il chatbot istruito. Gli do il documento, il ruolo, il formato e i vincoli.
Ho proiettato il prompt che ha funzionato sul caso Meroni, smontandolo pezzo per pezzo, e ho ricavato quattro regole da scrivere sempre:
- ancorare a un documento specifico;
- vietare il riempimento delle lacune: se l’informazione manca, il sistema deve scrivere che manca;
- dire che cosa non deve fare, non solo che cosa deve fare;
- chiedere il percorso e la motivazione, non soltanto l’esito.
Qui sta anche la distinzione che considero più utile: reperire non è elaborare. Le fonti si prendono dove stanno, in Normattiva, in EUR-Lex, nelle banche dati parlamentari; il modello lavora sul materiale reperito, non sulla propria memoria. Il rischio opposto ha un nome: restare dentro il dialogo credendo di fare ricerca.
Ho raccontato un caso in cui la ricerca è uscita dai binari, e come l’ho fermata.
Terzo gradino: il chatbot personalizzato. Le istruzioni si scrivono una volta sola. Ho costruito un assistente su come si costruisce un articolo scientifico e uno che conosce il mio modo di scrivere.
Il passo successivo è l’agente: non più uno strumento che risponde quando lo interrogo, ma un’attività che parte da sola, a cadenza fissa, e mi porta il risultato. Con due condizioni che non sono facoltative: il perimetro delle fonti lo definisco io, prima; e l’esito è un risultato che leggo, non un’azione che qualcuno esegue al posto mio.
Quarto gradino: il chatbot ancorato a un corpus. Il corpus si sceglie in funzione del compito: per le sentenze un corpus di massime di legittimità e di merito, per le norme Normattiva, EUR-Lex, i dossier dei Servizi studi.
Qui c’è il punto che riguarda più da vicino il tema della masterclass. Il modello non possiede una nozione di vigenza. La norma è un oggetto a versioni multiple, originaria, intermedie, vigente, e il modello le ha viste mescolate. Per questo il testo di una norma non si chiede: si fornisce.
Un esempio: riformare la legge 241 del 1990
Ho chiuso con un esperimento condotto il 25 giugno 2026. Non ho chiesto «scrivi una legge»: ho fornito il testo vigente della legge 7 agosto 1990, n. 241, e ho chiesto come modificarlo per digitalizzare il procedimento, per introdurre modalità concrete di uso degli strumenti informatici e per impiegare l’intelligenza artificiale nell’istruttoria.
Il sistema ha proposto un quadro di modifiche, poi si è fermato e ha posto quattro domande: automazione spinta nei procedimenti vincolati o firma sempre umana? nullità o annullabilità dei provvedimenti privi di supervisione? una norma transitoria? un coordinamento esplicito con l’AI Act?
Ho risposto io, e sono decisioni di politica del diritto. La macchina non ha deciso nulla: ha posto le domande. È esattamente il modo in cui mi pare utile impiegarla.
Il passo successivo
Nel mio libro «Il problem solving nelle professioni legali» ho descritto in nove passaggi il percorso che porta dal problema sociale alla norma. Per ciascun passaggio la domanda è la stessa: come e quando usare l’intelligenza artificiale generativa. A mio avviso i passaggi in cui serve davvero sono quattro.
Ma di questo parleremo un’altra volta.
Una considerazione finale
Attività formative di questo tipo sono a mio avviso indispensabili. Il valore aggiunto di questa masterclass mi pare stia nella felice intuizione di mettere a fattor comune le esperienze, interdisciplinari e professionali, che ognuno sta facendo per costruire le competenze necessarie a usare questi strumenti.
Nuove competenze per nuovi strumenti, costruite attraverso l’apprendimento collaborativo.
Ringrazio Davide De Lungo, direttore della masterclass e consigliere parlamentare della Camera dei deputati, per avermi chiesto di portare il mio personale punto di vista.
Per approfondire
- Le slide che ho proiettato (pdf)
- Pascuzzi, G., Intelligenza artificiale generativa (inventario delle piattaforme per i giuristi)
- Pascuzzi, G., Le delibere del CSM sull’intelligenza artificiale nell’amministrazione della giustizia
- Pascuzzi, G., Intelligenza artificiale e sistema giudiziario: quella piattaforma che ancora non c’è
- Pascuzzi, G., Intelligenza artificiale generativa e giustizia amministrativa
- Pascuzzi, G., Sulle sentenze «allucinate» dall’intelligenza artificiale
- Pascuzzi, G., Rallentare l’intelligenza artificiale? Sulla proposta del fondatore di Anthropic
- Pascuzzi, G., Come si insegna agli studenti di Giurisprudenza l’uso proficuo dell’intelligenza artificiale generativa?
- Pascuzzi, G., Educare all’uso dell’intelligenza artificiale. Il ruolo di scuole e università
- Pascuzzi, G., La regolazione delle tecnologie emergenti